마피아 게임서 승률 24%p 껑충…상대 속마음 읽는 ‘눈치 100단’ AI 등장

유용하 기자
수정 2026-11-01 14:37
입력 2026-11-01 11:40
세줄 요약
- UNIST, 상대 의도 추론형 AI 학습법 마르보 개발
- 마피아 게임 승률 24%포인트 상승, 추론력 강화
- 웨어울프·어몽어스서도 AI 성능 대폭 향상 확인
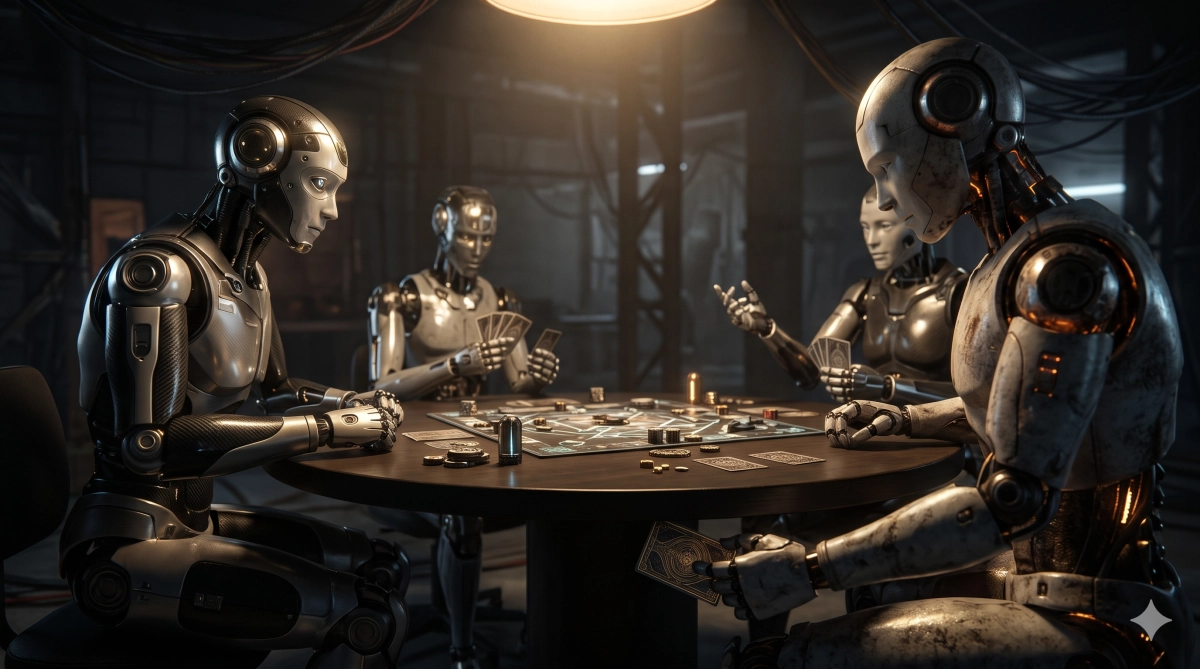
울산과학기술원(UNIST) 인공지능대학원 연구팀은 상대의 역할과 의도를 스스로 추론하고 그 판단에 맞춰 말하고 행동하도록 대형 언어 모델(LLM) AI를 훈련하는 기술 ‘마르보’를 개발했다고 1일 밝혔다. 이 학습법을 적용한 AI는 마피아 게임에서 기존 학습법을 거친 AI보다 평균 승률이 24%포인트 높았다. 이 연구 결과는 지난달 24~29일 헝가리 부다페스트에서 열린 자연어 처리 분야 국제 학술대회 ‘EMNLP 2026’에서 발표됐다.
여러 AI가 함께 일하는 다중 에이전트 환경에서는 정보가 부족하거나 상대가 일부러 속일 수 있다. 기존 AI는 논리가 비약된 상대의 말을 그대로 믿거나 누군가를 의심하면서도 엉뚱한 참가자에게 투표하는 실수를 보였다. 추리 과정보다 결과가 유리한지를 판단하도록 배웠기 때문이다.
마르보는 세 단계로 AI를 가르친다. 우선 쌓인 대화와 행동을 바탕으로 상대가 어떤 역할이고 누구와 한편인지 추리하게 했다. 연구팀은 이 추정을 ‘관계적 믿음’이라고 부른다. 이어 상대의 정체를 정확히 판단하고 목표에 유리한 행동을 고른 경우에만 좋은 평가를 준다. 잘못 추리했는데 운 좋게 이긴 경우는 걸러내는 것이다. 마지막으로 말을 할 때는 상대가 나를 어떻게 보는지까지 고려해 내 말을 들은 상대의 판단이 내게 유리하게 바뀌었는지 확인하도록 했다. 함께 게임하는 AI 조합도 무작위로 바꿔 다양한 상황을 겪게 했다.
연구팀은 시민 속에 숨은 늑대인간을 찾는 ‘웨어울프’, 우주선 임무를 방해하는 배신자를 가려내는 ‘어몽어스’에서 AI끼리 대결시켰다. 두 게임 모두 참가자마다 아는 정보가 다르고 거짓말도 허용되는 ‘사회적 추론 게임’이라 상대의 속내를 읽는 능력이 승패를 가른다.
매개변수 70억 개짜리 언어 모델을 마르보로 훈련하자 웨어울프에서 다섯 종류의 상대 AI와 겨룬 평균 승률이 41.6%에서 65.6%로 뛰었다. 매개변수가 2배인 모델을 기존 방식으로 훈련했을 때(64.0%)보다도 높다. 상대가 시민 편인지 늑대인간 편인지 가려내는 정확도도 44.8%에서 66.0%로 상승했다. 어몽어스에서는 구글의 경량 모델 ‘젬마4’ 두 종의 승률이 각각 36.4%에서 49.0%로, 40.0%에서 59.0%로 높아졌다. 이 성적은 AI끼리 겨룬 결과로, 사람을 상대로 한 성능은 아직 검증되지 않았다.
연구를 이끈 한승열 교수는 “이번 기술은 불완전하거나 기만적인 정보가 존재하는 상황에서도 상대의 역할과 관계를 추론하며 제대로 된 판단을 할 수 있게 해준다”며 “다중 로봇, 자율 드론, 인간-AI 협업 등 여러 에이전트가 서로의 상태와 의도를 이해하며 협력해야 하는 시스템의 신뢰성과 적응성을 높이는 기반 기술로 확장될 수 있을 것”이라고 말했다.
유용하 과학전문기자
Copyright ⓒ 서울신문 All rights reserved. 무단 전재-재배포, AI 학습 및 활용 금지
[ 내안의 AI 본성 분석 :
UNMASK ]
기사 읽는 습관에 숨겨진 당신의 MBTI는?
Q.
기사를 다 읽으셨나요? AI 퀴즈로 핵심 점검!
마르보 학습법을 적용한 AI의 핵심 특징은 무엇인가?